Qwen Image 3.0 vs GPT Image 2:2026 繁中設計實測
從繁中文字體 QA、英文長文、UI、速度與畫質,比較 Qwen Image 3.0 vs GPT Image 2,附可重現評測流程與 X 來源。
 Qwen Image 3.0

本文圖片是依教學情境重新生成的目標參考,不宣稱是 Qwen 或 GPT 的真實輸出。
先講結論。這一輪 Qwen Image 3.0 vs GPT Image 2 的公開討論,整體贏家仍是 GPT Image 2。它在英文長文、細節、人物與生成速度上比較穩。Qwen Image 3.0 的進步也很具體:中文資訊較完整,密集版面和 UI 能進入實際工作流程,發布期的免費或低價存取讓它更容易被團隊拿來試。
繁體中文使用者還要多問一層。社群裡最亮眼的中文案例多是簡體字,不能直接推論繁中同樣穩。臺灣品牌會遇到「台/臺」、「里/裡」、全形標點、直排、注音或在地用語。Qwen Image 3.0 vs GPT Image 2 真正有用的比較,應把這些內容放進自己的固定測試集。
Qwen Image 3.0 vs GPT Image 2:資料來源與判讀範圍
最完整的公開實測來自 thehypedotnews。他用超市傳單、精緻菜單、數據儀表板、報紙專欄與時尚封面做五次壓力測試。GPT Image 2 贏四項,時尚封面接近平手。該次測試裡,GPT 約一分鐘完成,Qwen 多數花兩到四分鐘。
這不是固定種子、同一後端負載的實驗室測試。時間只能寫成「該次觀察」,不能寫成模型承諾。價格也是同理。X 使用者說 Qwen 免費、便宜或在國內可用,描述的是當時入口,不代表永久條款。
| 判斷項目 | 公開資料支持 | 公開資料沒有證明 |
|---|---|---|
| 綜合品質 | GPT 在多數直接對比領先 | 每一項測試都會贏 |
| 速度 | thehype 的五次生成中 GPT 較快 | 固定等待時間 |
| 中文排版 | Qwen 在數個簡中案例保留較多文字 | 繁中、直排與小字都零錯 |
| 英文長文 | GPT 菜單與報紙正文較乾淨 | 不需要人工校對 |
| 免費替代 | 發布期 Qwen 存取成本較低 | 永久免費 |
來源、時間與限制寫清楚,這篇比較才有可信度。
Qwen Image 3.0 vs GPT Image 2 Features 功能表
| 功能 | Qwen Image 3.0 | GPT Image 2 | 設計工作建議 |
|---|---|---|---|
| 畫面細節 | 比 2.0 進步,局部仍會糊、雜或不合物理 | 多組樣張更豐富、柔和、穩定 | GPT |
| 英文長文 | 菜單拼字與報紙正文仍可能失敗 | 引用測試較乾淨連貫 | GPT |
| 中文資訊 | 簡中標籤與層級常較完整 | 第一眼較漂亮,但蘇州案例中文錯 | Qwen,繁中另測 |
| 密集排版 | 能放進更多內容,也可能太滿 | 取捨和留白通常更成熟 | 看 brief |
| UI | 社群認為結構能力突出 | 完成度常更高 | Qwen 探索、GPT 精緻稿 |
| 人臉與一致性 | 仍有人臉、噪點與局部邏輯批評 | 角色參考排序較高 | GPT |
| 該次速度 | 多數約 2–4 分鐘 | 約 1 分鐘 | GPT |
| 成本 | 發布期常被描述為免費或低價 | 依產品入口而異 | 上線前重查 |
mark_k 的貼文 在提供的資料中約有 311 個讚、1.7 萬瀏覽。他認為 Qwen 3.0 是大幅進步,整體畫質與可靠度仍離 OpenAI 有距離。這個判斷和多數英文圈回覆一致。
Qwen Image 3.0 vs GPT Image 2:五個案例看出什麼
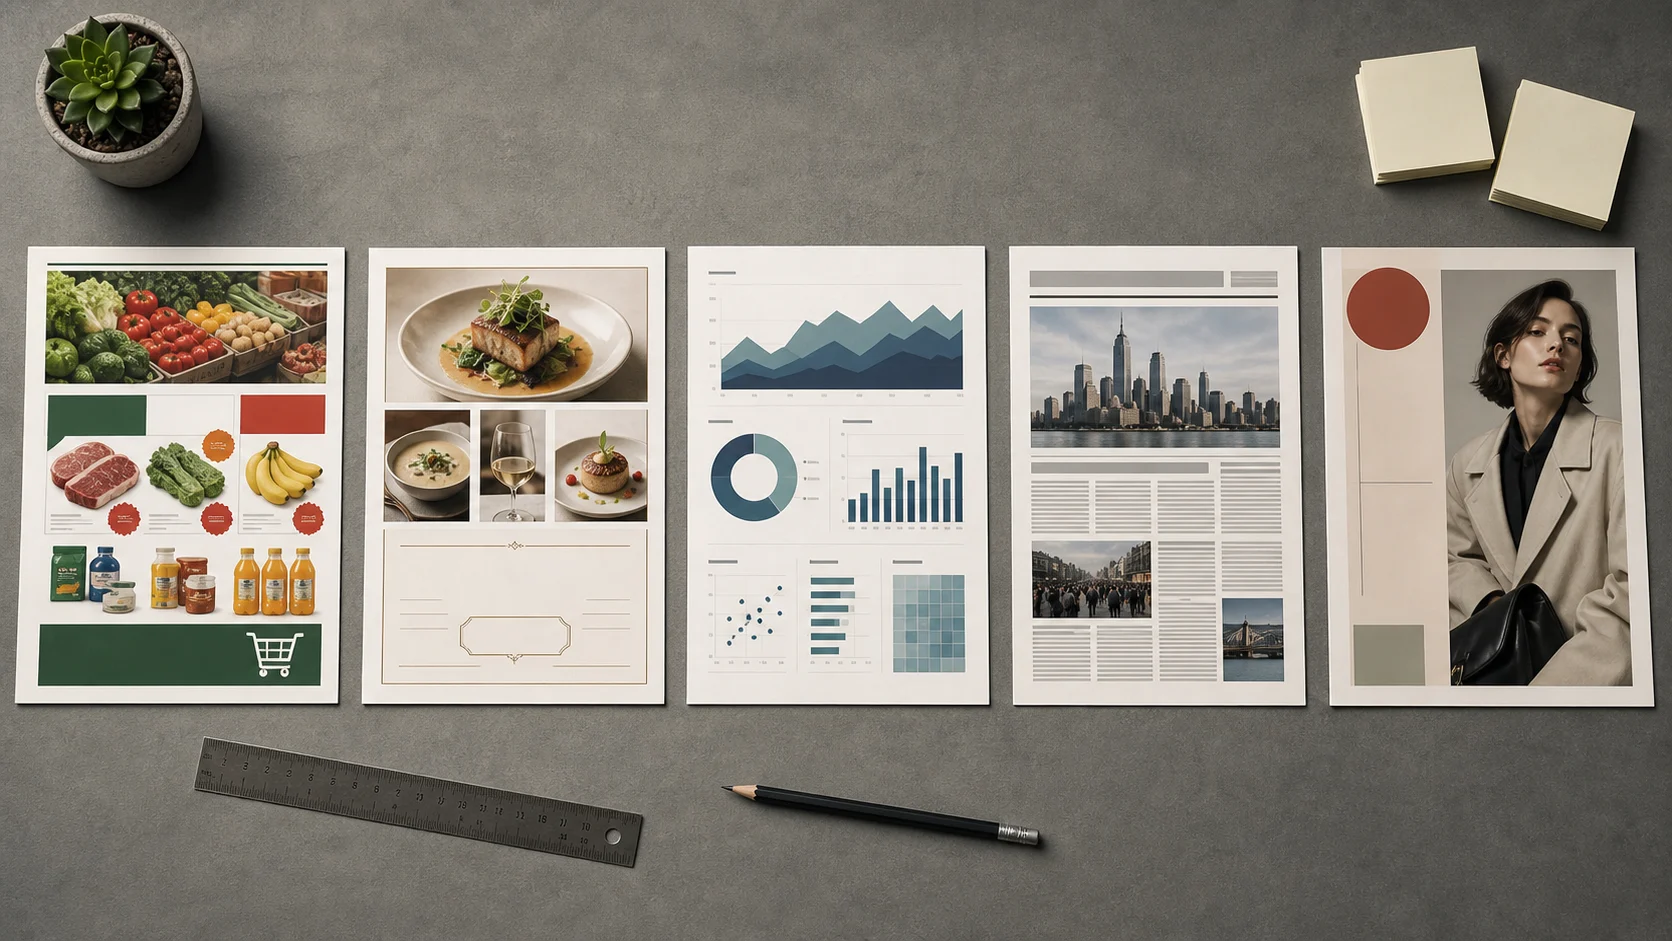
參考板只呈現測試類別,不是模型輸出。
傳單測版面分組。GPT 比較像完成的廣告,Qwen 放進更多訊息卻容易頭重。lionman888888 對中文海報也有相近觀察:Qwen 的文字、層級和國潮質感最完整,但過滿;GPT 的第一眼衝擊最強。
菜單測拼字和標點。Qwen 出現 “thryme” 與 “rosted fennel”,GPT 正確保留 “crème fraîche”。這類錯誤不能靠「看起來像字」過關。
儀表板說明 Qwen 的專項價值。pwnies 認為它是少數能好好畫 UI 的 diffusion 模型之一。GPT 的視覺完成度較高,Qwen 的結構已能用來探索頁面。
報紙測長文。GPT 產生較合理的新聞正文;Qwen 正文像亂碼,球衣也出現不合理條紋。時尚封面接近平手,這一項應由美術方向決定。
Qwen Image 3.0 vs GPT Image 2 Tutorial:繁中團隊怎麼測
- 準備一份 80 至 120 字的繁中測試文案,混入標題、價格、地址、全形標點和一組容易混淆的異體字。
- 鎖定同一比例、色盤、物件與版面約束。
- 每個模型生成四張,任何失敗都不刪。
- 先讓文字編輯計算錯字、漏字、簡繁混用和多餘字。
- 再讓不知道模型名稱的設計師評版面、留白、焦點和品牌調性。
- 記錄修正分鐘數。這比只看最美的一張更接近交付成本。
| 批次 | 字形正確 | 用語正確 | 版面階層 | 視覺品質 | 跨張穩定 | 修正分鐘 |
|---|---|---|---|---|---|---|
| Q1–Q4 | /5 | /5 | /5 | /5 | /5 | |
| G1–G4 | /5 | /5 | /5 | /5 | /5 |
Qwen Image 3.0 vs GPT Image 2 Use Case:中文活動海報
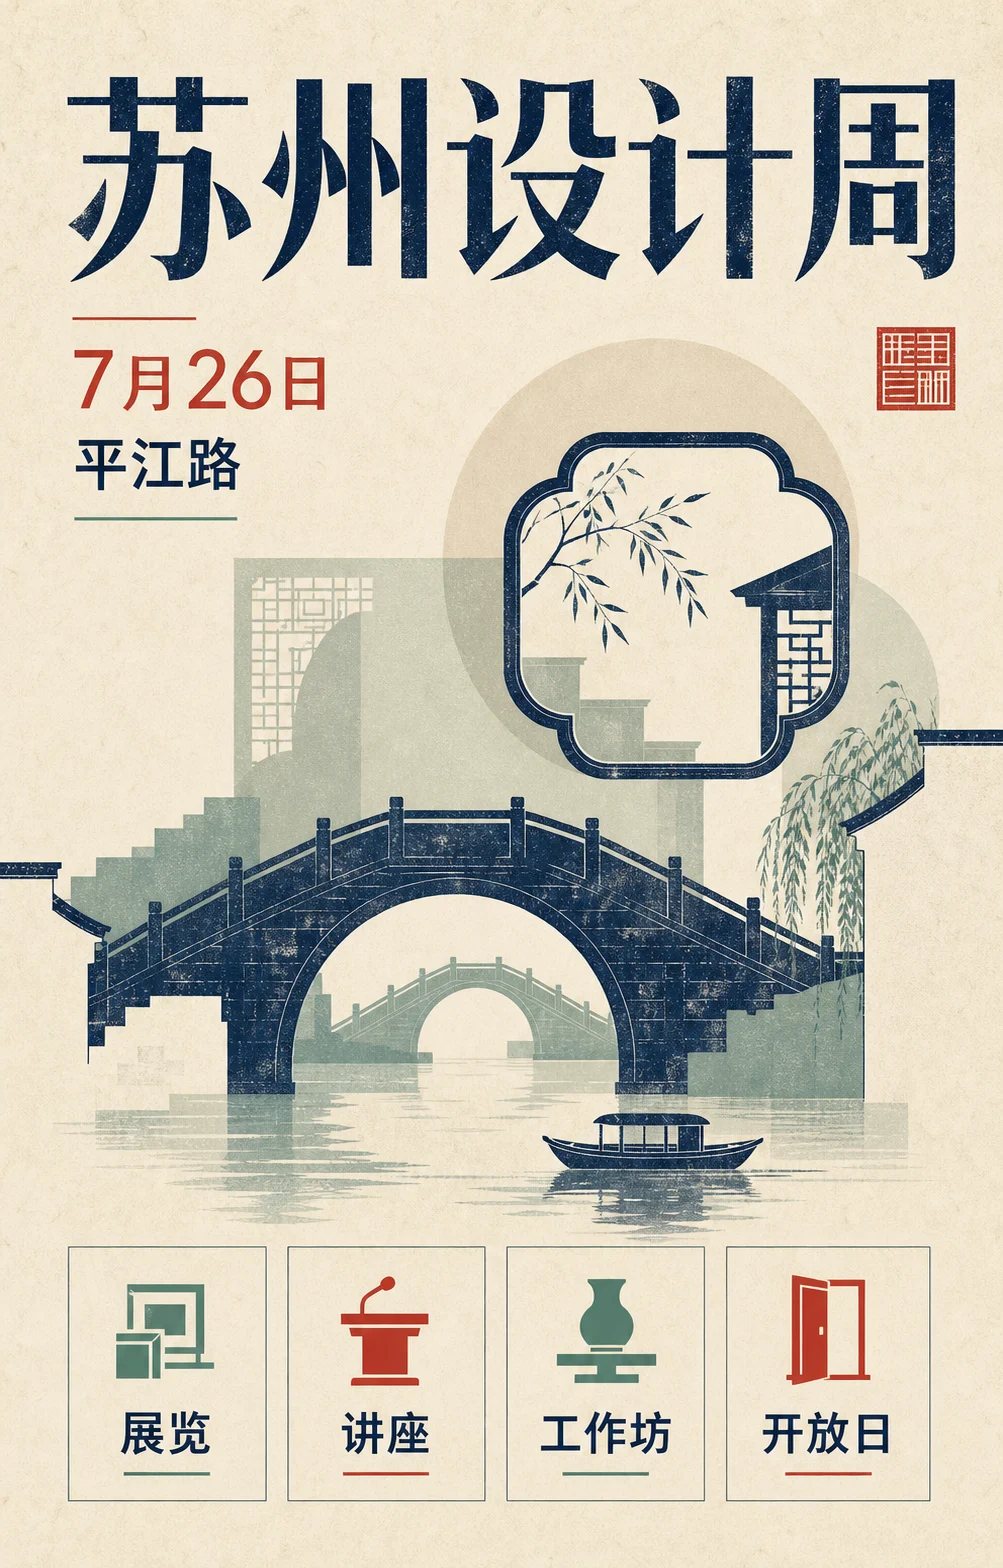
內部測試簡報應鎖定直式交付比例、不可改動的中文文案、少量地域視覺元素和固定資訊網格。兩個模型使用同一份機密簡報,再統計漏字、異體字、重複文字和底部模組是否等寬。
Simon 的蘇州比較 顯示 GPT 整體視覺更好,中文標註失敗;Qwen 中文較準,畫面不如 GPT。繁中版本可以把文案換成「臺北設計週」「週末工作坊」,專門看模型會不會自動轉簡體。
Qwen Image 3.0 vs GPT Image 2 Use Case:餐飲菜單
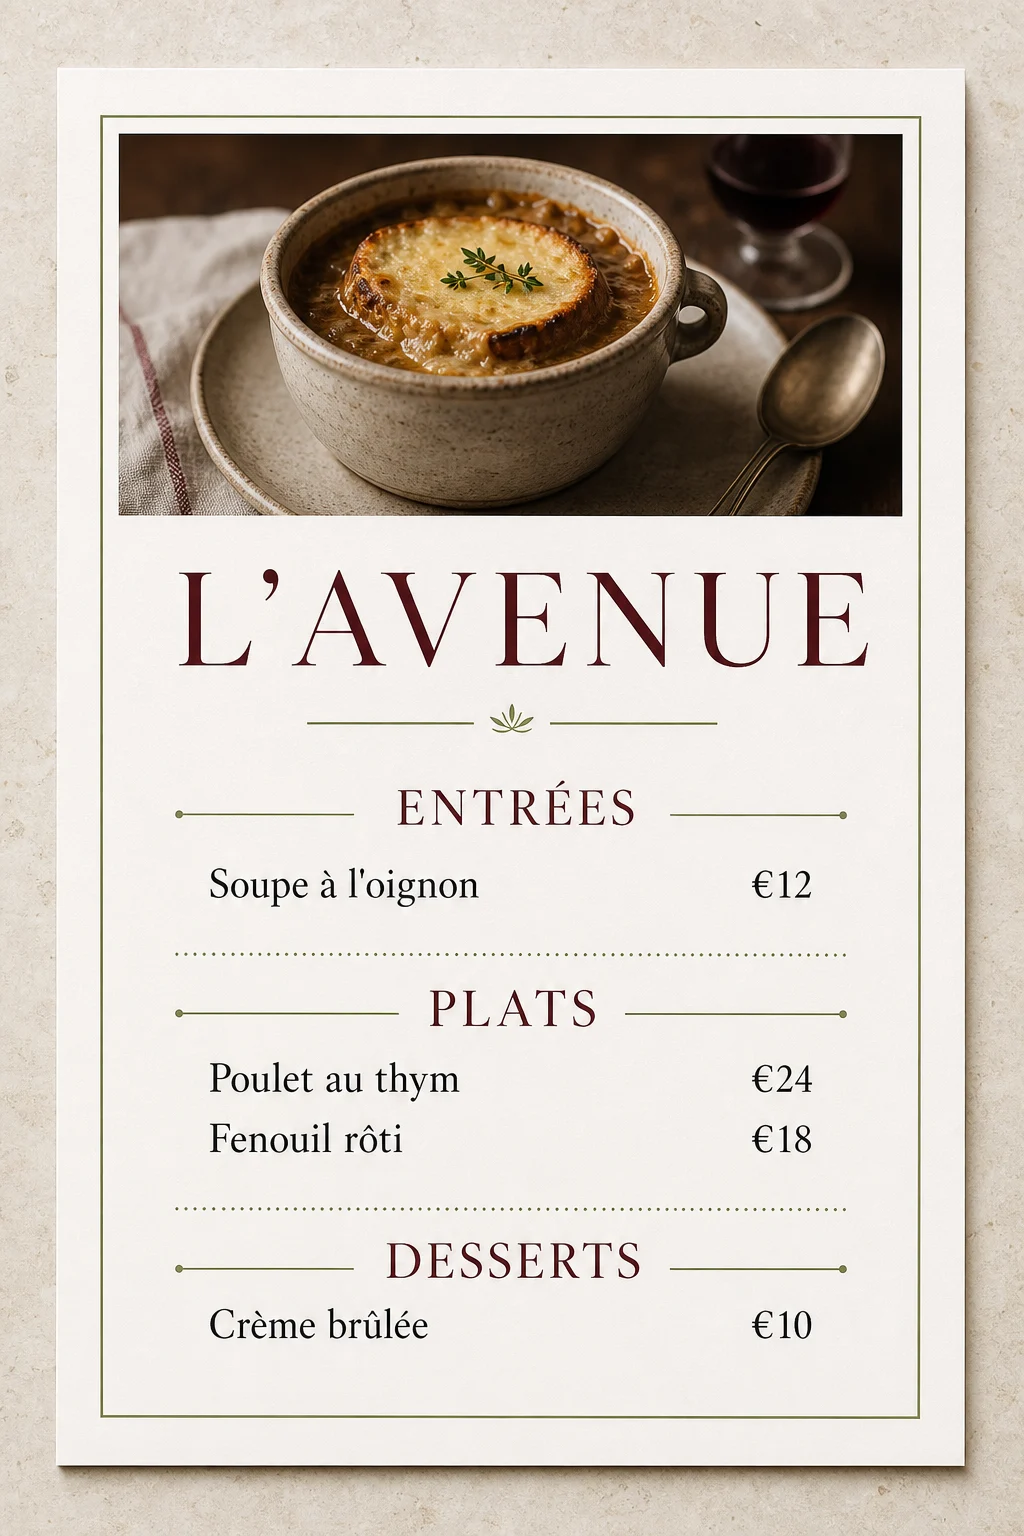
菜單測試可在內部文案加入重音、撇號、價格、欄目標題和對齊規則,但不公開完整校驗內容。檢查重音、重複單字、價格與基線。依現有 Qwen Image 3.0 vs GPT Image 2 證據,GPT 較適合先跑英文或法文長文,但仍要人工校字。
Qwen Image 3.0 vs GPT Image 2 Use Case:UI 儀表板
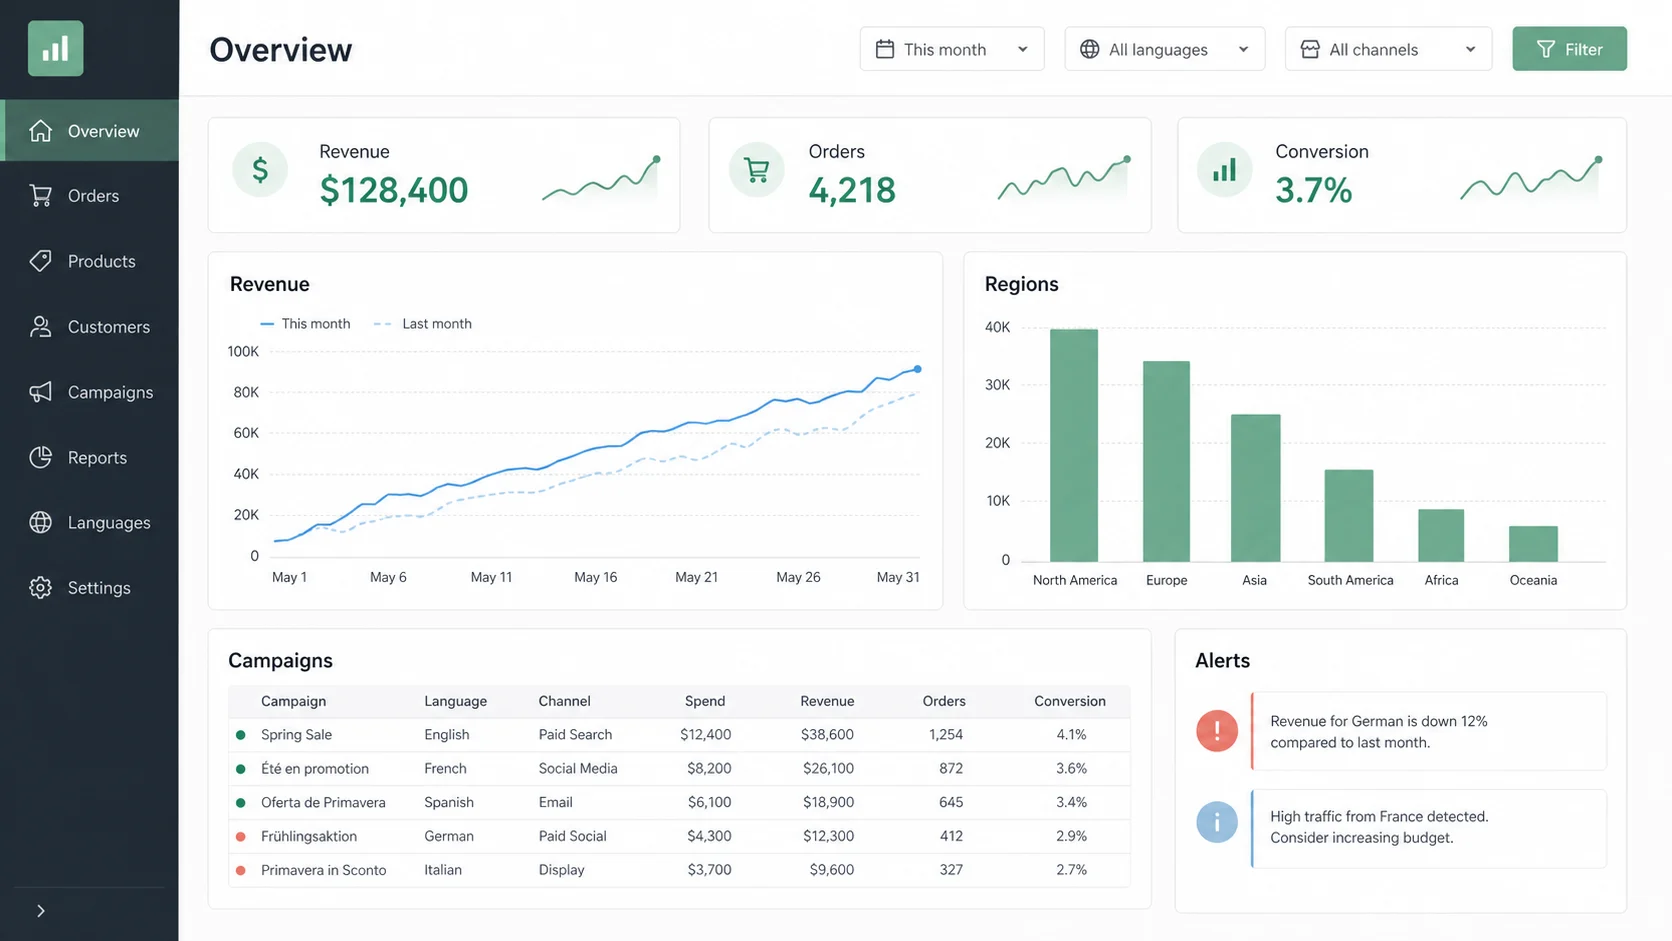
UI 測試應在內部規格固定導覽結構、KPI 數量、圖表類型、表格欄位和標籤集合。檢查圖表軸、表格欄與重複元件間距。Qwen 可用來快速找結構,GPT 較容易得到成熟的視覺方向。兩者都不能取代真正的設計系統。
Qwen Image 3.0 vs GPT Image 2 User Testimonials
- Xudong07452910 認為 GPT 內容更豐富、顏色更柔、細節更穩;Qwen 免費所以仍有競爭力。
- aiden_cckk 看到 Qwen 雜色較多,審美卻略偏 Qwen。偏好和可靠度是兩件事。
- chuyouqi 的角色參考排序把 GPT Image 2 放第一、Qwen 3.0 第二。
- cedric_chee 認為偽影改善,typography 仍不及 GPT,並批評 3.0 轉為封閉。
- AbleGPT 則分享中文長文、多語、UI 和編輯接近 Image 2 的正面案例。
Qwen Image 3.0 是最佳 GPT Image 2 alternative free 嗎
若工作集中在中文資訊、高密度海報、UI 概念與大量低成本試錯,Qwen 很值得排進第一輪。免費要附日期,正式導入前重新確認價格、額度和商用條款。
英文長文、寫實細節、人物與快速迭代優先時,GPT Image 2 仍是較安全的選擇。繁中團隊不要只沿用簡中結論,應把本地字形和用語放進固定測試集。
Qwen Image 3.0 vs GPT Image 2 FAQ
Qwen 已經超越 GPT Image 2 嗎?
現有證據不支持。GPT 綜合領先,Qwen 在中文密集版面和 UI 有局部優勢。
繁中海報可以直接交付嗎?
不建議。日期、價格、地址、品牌字與異體字都應逐字校對,最終文字最好回到 Figma 或其他排版工具。
怎麼選才不會被單張樣圖誤導?
用同一份內部簡報至少各跑四張,把錯字率和返工分鐘寫進表格。若只看一張最好看的圖,測到的是挑圖能力。
目前合理的結論很克制:GPT Image 2 仍是全能選擇,Qwen Image 3.0 已經值得繁中設計團隊自己跑一輪。回首頁試用 Qwen Image 3.0,用同一份檢查表記錄結果,再決定要不要進正式流程。